人工智能基础软件开发 2025年行业研究与发展趋势
人工智能基础软件是支撑AI应用落地的核心底座,涵盖深度学习框架、分布式训练平台、推理引擎、编译器与算子库等关键组件。2025年以来,该领域呈现出开源生态深化、软硬件协同优化、大模型训练与推理效率并重等显著趋势。金准数据基于全网公开信息与行业调研,对人工智能基础软件开发的最新进展进行系统梳理与分析。
一、行业概述与范围界定
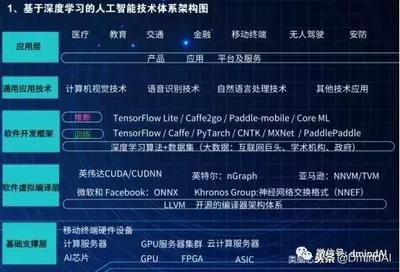
人工智能基础软件位于AI技术栈的中间层,向上支撑算法模型开发,向下适配异构算力。根据功能可划分为四类:一是深度学习框架(如PyTorch、TensorFlow、PaddlePaddle),提供模型构建与自动微分能力;二是分布式训练与推理平台(如DeepSpeed、vLLM、TensorRT-LLM),解决大规模模型的高效并行与部署问题;三是AI编译器与算子库(如TVM、Triton、OneDNN),负责计算图的优化与硬件指令生成;四是数据标注、实验管理与MLOps工具链,覆盖模型全生命周期管理。2025年,随着千亿参数级模型进入常态化训练与推理阶段,基础软件的性能瓶颈从单纯的算力供给转向系统级效率优化,软硬件协同设计成为核心竞争力。
二、技术进展与创新热点
在训练侧,混合并行策略(数据并行、张量并行、流水线并行的组合)与显存优化技术(Zero冗余优化器、激活重计算、量化训练)已趋成熟。2025年的新进展集中在三点:其一,编译与图优化向动态shape场景延伸,Torch.compile与XLA在动态控制流上的支持显著增强;其二,通信与计算的重叠调度更加精细化,NVSHMEM与NCCL的融合调度成为大厂标配;其三,国产硬件适配加速,多家框架已完成对昇腾、寒武纪、海光等芯片的正式支持,并在算子覆盖率与性能调优上取得突破。推理侧,以vLLM为代表的连续批处理(continuous batching)与PagedAttention技术大幅提升了吞吐量,推测解码(speculative decoding)与FlashDecoding的工程落地也在2025年明显加速。与此AI编译器领域Triton语言生态快速扩张,降低了自定义高性能算子的开发门槛,成为连接框架与硬件的关键中间层。
三、竞争格局与主要参与者
全球范围内,PyTorch凭借学术生态与灵活性继续保持框架层主导地位,TensorFlow在工业部署存量市场仍具影响力,JAX在科研与高性能计算场景增长较快。国内方面,飞桨(PaddlePaddle)在产业落地与国产硬件适配上形成差异化优势, MindSpore在昇腾生态内深度耦合,OneFlow等后起框架聚焦分布式训练效率。互联网大厂(阿里、字节、腾讯)基于内部超大规模模型训练需求自研训练平台与推理引擎,并以开源方式对外输出,形成“内部打磨、外部开源”的路径。创业公司则集中在推理引擎、模型压缩工具链与MLOps细分赛道,保持较高的产品迭代节奏。整体格局呈现“框架层收敛、工具层活跃”的特征。
四、关键挑战与风险
第一,软硬件协同的碎片化问题突出。不同芯片厂商的编译器栈、算子库与通信库差异较大,框架层需为每类硬件维护大量条件分支,维护成本高且性能一致性难以保证。其二,大模型全生命周期的系统复杂度攀升居高不下,训练稳定性、故障恢复与可观测性仍是工程难题。第三,开源项目的商业化与社区治理之间存在张力,部分项目的贡献集中度较高,可持续性有待观察。第四,政策与合规层面,模型训练数据来源、生成内容追溯等要求对软件工具链的数据管理能力提出新约束。
五、趋势展望与建议
未来12至18个月,人工智能基础软件开发有望沿三条主线演进:一是“编译优先”理念进一步普及,框架与编译器的边界趋于模糊,图模式(graph mode)与即时执行模式的效能差距收窄;二是推理基础设施持续精细化,面向AI Agent与多模态场景的异构流水线调度成为新战场;三是国产基础软件在行业信创与央国企场景中迎来验证窗口,性能达标与生态兼容是成败关键。建议优先在推理侧投入资源构建自有优化能力,评估开源软件的法律与维护风险,并建立跨部门的基础软件专属团队;对于开发者,掌握Triton/AI编译器原理、熟悉分布式并行策略、积累国产硬件适配经验,将成为较为稀缺的技能方向。
如若转载,请注明出处:http://www.xuetaotie.com/product/47.html
更新时间:2026-10-22 13:03:25